Feito para logs, dumps CSV e SQL, exportações JSON e qualquer arquivo de texto que trava outros editores.
Abre arquivos de qualquer tamanho
Só a parte visível é lida: no Windows por janelas mapeadas na memória, no Linux e no macOS em blocos quando necessário. O trabalho em segundo plano processa o resto, e unidades de rede ou USB passam para leituras em blocos com cache, então um disco lento nunca trava a janela.
Vá para uma linha na hora
Um índice de linhas esparso (8 bytes a cada 64 KB) é criado em segundo plano a 2,5 GB/s. Ir para a linha e a barra de rolagem funcionam de imediato, mesmo antes de a indexação terminar.
Pesquisa rápida e regex
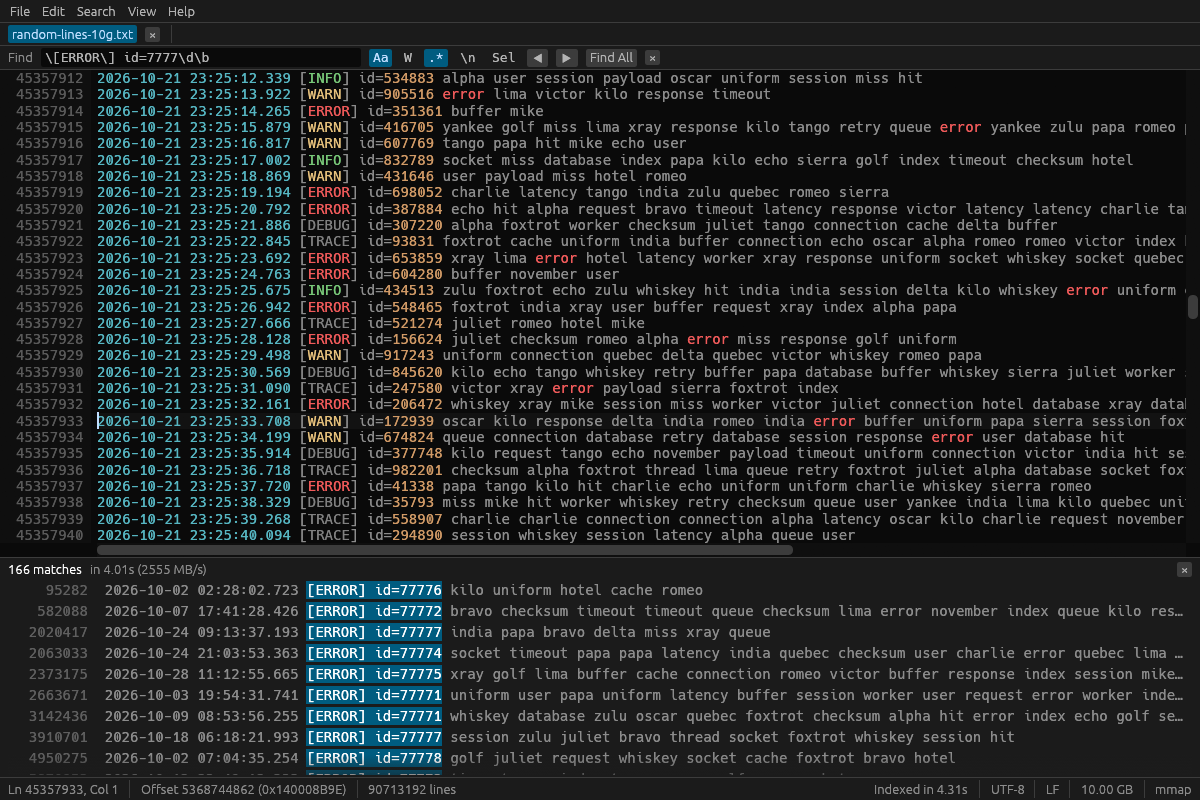
Texto simples a 2,5 GB/s e expressões regulares em tempo linear, com opções de maiúsculas, palavra inteira e várias linhas. “Localizar todos” lista até um milhão de resultados; F3 funciona na hora.
Substituir em gigabytes
Substitua com $1 e grupos nomeados. Até 50.000 alterações são uma única edição que pode ser desfeita; trabalhos maiores são gravados num arquivo novo: 22 milhões de substituições num arquivo de 10 GB levaram 11 s e usaram 46 MB de RAM.
Edição de verdade
Digitar, recortar, copiar, colar, desfazer e refazer, duplicar ou excluir linhas, recuo automático, sobre uma piece table, de modo que as edições não reescrevem o arquivo até você salvar.
Salvamento à prova de falhas
Ao salvar, um arquivo temporário é gravado, enviado ao disco e substitui o original de forma atômica. Uma falha ou queda de energia nunca deixa um arquivo pela metade. Cópias .bak opcionais.
Codificações e visualização hex
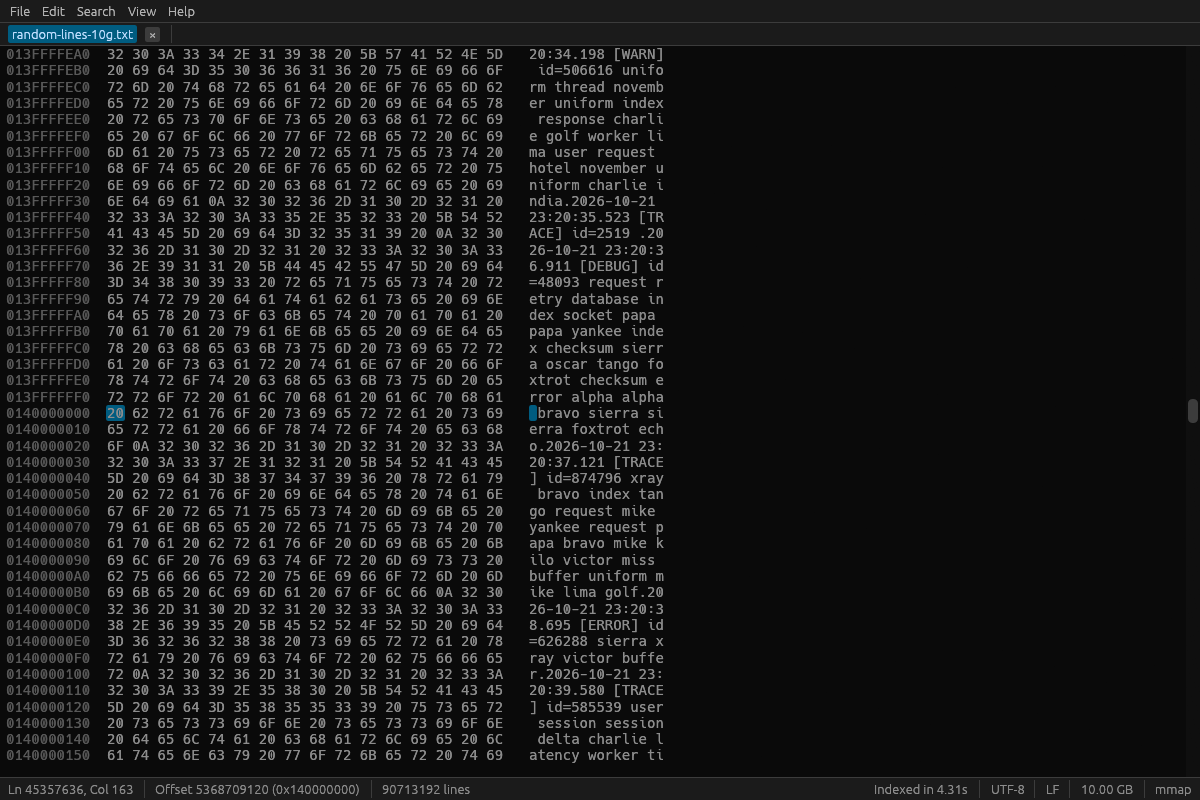
UTF-8, UTF-16 LE/BE, Windows-1251, Windows-1252 e ISO-8859-1 são detectados automaticamente; finais de linha LF, CRLF e CR são mantidos ou convertidos. Arquivos binários abrem numa visualização hexadecimal.
Ferramentas para logs
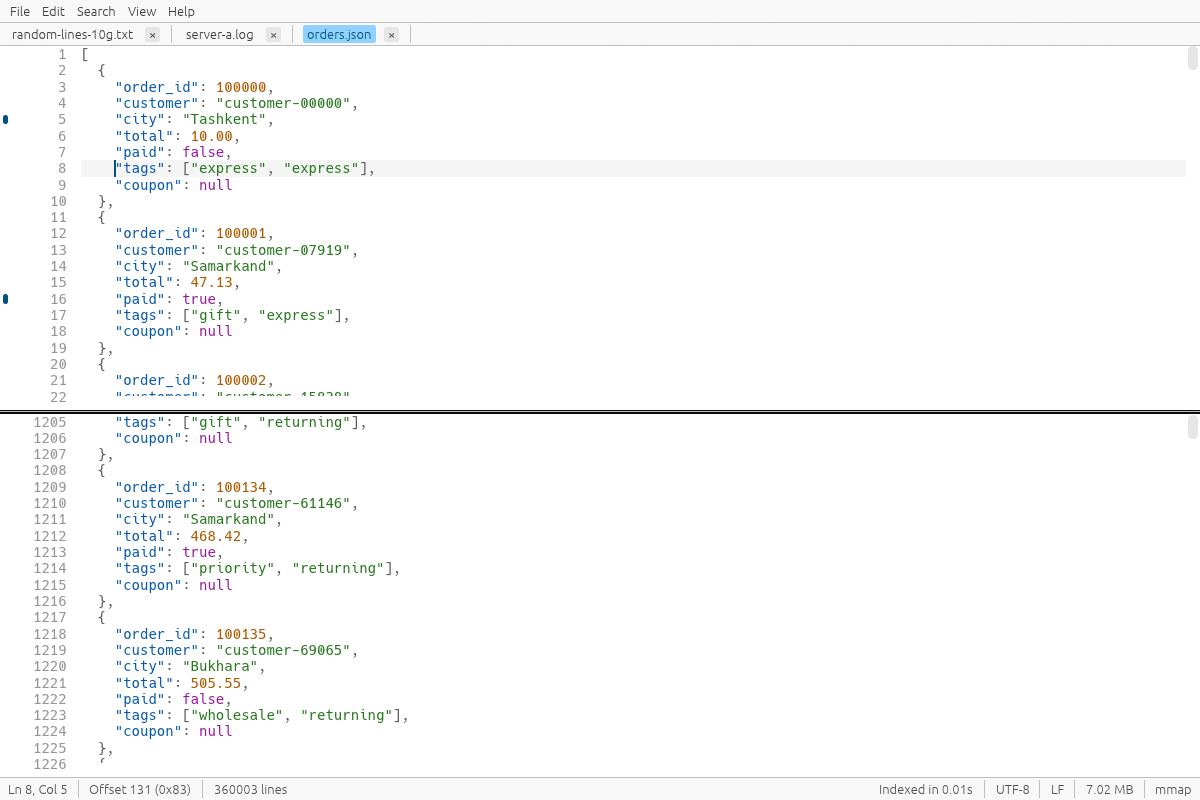
Modo acompanhar (como tail -f) para logs que crescem, realce de sintaxe para logs, JSON, XML, CSV, SQL e INI, marcadores e uma visualização dividida de um arquivo.
Compare arquivos enormes
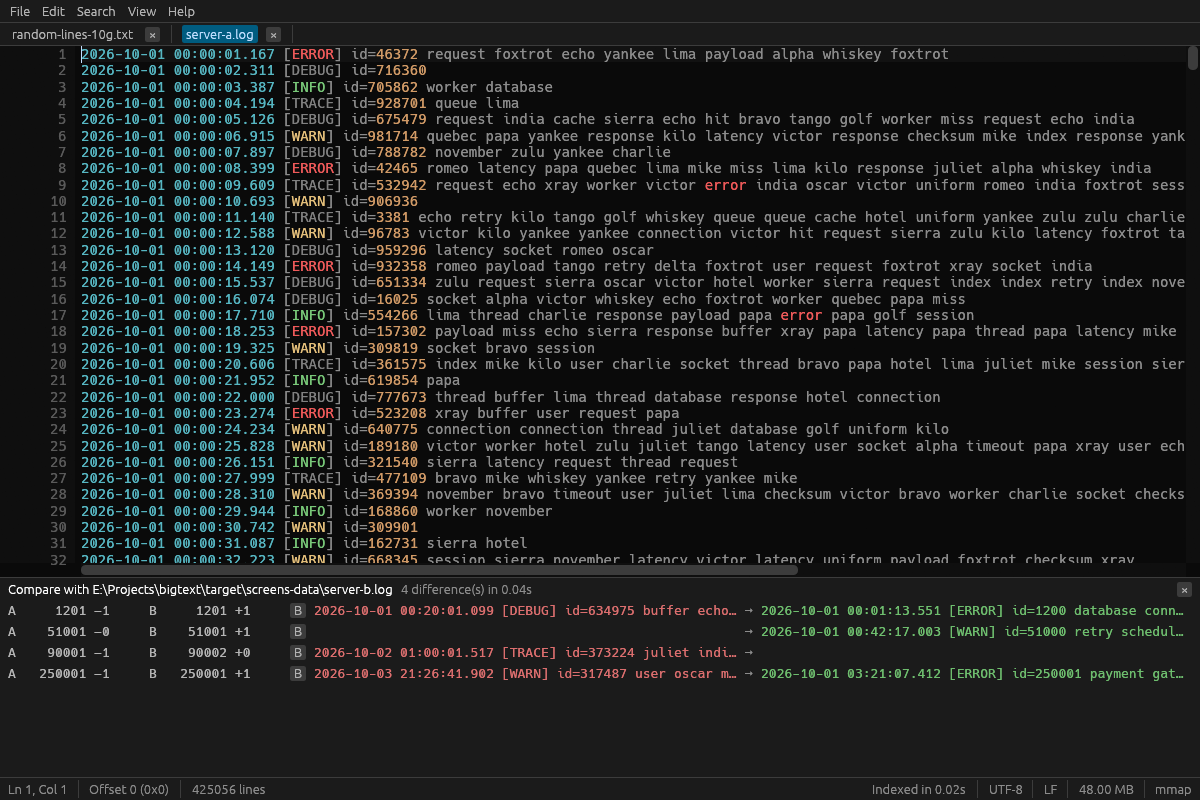
Uma comparação de linhas em streaming de dois arquivos de vários gigabytes: 1 GB contra 1 GB em 0,6 s com cerca de 2 MB de memória. Clique numa diferença para ir até ela.
Filtrar e realçar
Mostre só as linhas que correspondem, ou só as que não, como o grep sobre o arquivo inteiro, e salve-as num arquivo novo. Pinte padrões como ERROR com cores próprias e veja na barra de rolagem onde os resultados se concentram.
Pular para um horário
Digite 14:32:05 e chegue à primeira linha do log com esse horário: uma busca binária lê algumas centenas de kilobytes de um log de 50 GB. Selecione linhas para ver o tempo entre elas.
Logs compactados e pipes
Abra arquivos .gz e .zst diretamente, envie um comando ao BigText por pipe (journalctl -f | bigtext -) ou abra app.log:120 numa linha pela linha de comando.
Tabelas CSV
Arquivos CSV e TSV abrem como uma tabela que rola tão rápido quanto texto. Ordene por uma coluna, veja estatísticas da coluna, filtre por uma coluna e renomeie, mova, exporte ou exclua colunas. Um registro com quebras de linha entre aspas é uma linha só.
Ferramentas de texto
Ordene, remova duplicatas e inverta linhas, mude maiúsculas, apare espaços, formate ou minifique JSON e edite muitas linhas de uma vez com uma seleção de coluna por Alt+arrastar.
Do seu jeito
Uma paleta de comandos (Ctrl+Shift+P), atalhos que você pode mudar, qualquer fonte monoespaçada e uma interface em inglês, russo, uzbeque, chinês, espanhol, português, alemão ou turco.
Análise de logs
Uma barra de níveis com filtros ERROR, WARN, INFO e DEBUG e F8 para o próximo erro, um histograma de tempo, campos do log, padrões de mensagens, valores mais frequentes, lacunas de tempo e as linhas em volta de cada resultado ou com o mesmo id de requisição.
Logs lado a lado no tempo
Mescle vários logs por data e hora numa visualização colorida, ou alinhe os logs abertos e role-os juntos pelo horário, com um desvio de relógio ajustável. O acompanhamento sobrevive à rotação de logs.
JSON e XML
Um painel de estrutura, o caminho JSON do cursor na barra de status, dobramento, JSON Lines como tabela com consultas, uma verificação rigorosa que aponta o erro, conversão entre JSON, JSON Lines e logfmt e uma comparação estrutural.
Tabelas que calculam
Agrupar com somas, tabelas dinâmicas, junção de dois arquivos por uma chave, colunas calculadas, gráficos de colunas, colunas fixas e ocultas, verificação de linhas e exportação para JSON, Markdown ou Excel.
Compare do seu jeito
Lado a lado ou como diff unificado, diferença seguinte e anterior, ignorar espaços, maiúsculas ou datas e horas, linhas que só estão em um arquivo, CSV comparado por chave e patches aplicados.
Arquivos compactados e grandes edições
Arquivos dentro de zip e tar, arquivos .xz e .bz2 exibidos enquanto descompactam, salvamento direto em .gz ou .zst, vários cursores, um editor de colunas e ordenar, remover duplicatas ou executar qualquer comando num arquivo de qualquer tamanho.
Localizar em arquivos e scripts
Pesquise uma pasta inteira com resultados arquivo:linha e use o bigtext-cli para count, head, tail, slice, replace, ferramentas CSV e saída JSON em scripts. Sessões, modo portátil, e uma segunda execução abre na janela que já está aberta.
Confortável para todos
Temas de alto contraste e seguros para daltonismo, escala da interface, suporte a leitores de tela, modo zen, quebra numa coluna com régua, uma barra de status clicável e configurações lembradas para cada arquivo.
Também um editor de código confortável
Cores de sintaxe para Python, JavaScript, TypeScript, Java, C#, C/C++, Go, Rust, PHP, scripts de shell, YAML e mais, em One Dark, Monokai, GitHub ou Solarized; uma barra lateral de pasta como no Sublime Text; Ctrl+P para achar um arquivo, Ctrl+R para as funções e classes de um arquivo, Ctrl+/ para comentar linhas e colchetes que se fecham sozinhos. Só as linhas na tela são coloridas, então um arquivo enorme continua igualmente rápido.
Logs em servidores
Abra user@server:/var/log/app.log por SSH com suas chaves, ou um arquivo https:// ou s3:// público, sem baixá-lo: só vem o que está na tela, e via SSH as buscas rodam no servidor. Ou acompanhe os últimos megabytes de um log como tail -F.
Logs de servidores web
Logs de acesso do nginx e do Apache, logs dos balanceadores de carga da AWS e do IIS, e syslog abrem como uma tabela com uma coluna por campo. O relatório do log web traz em uma passada as URLs principais, os erros 5xx por minuto e as requisições mais lentas: um log de 1 GB em menos de 2 segundos.
Logs de contêineres e serviços
Escolha em uma lista um contêiner Docker ou Podman, um pod do Kubernetes ou um serviço do systemd, neste computador ou em um servidor via SSH, e abra o log: as últimas linhas ou minutos, acompanhado enquanto cresce. Os reinícios de um pod aparecem, e a execução antes do último reinício, onde está o erro da queda, também abre.
Alertas de novas linhas
Dê a um log acompanhado alguns padrões, como ERROR ou uma expressão regular: cada nova linha que corresponde é contada na aba e anunciada com uma notificação do sistema e um som, no máximo uma a cada dez segundos. No Windows, um clique na notificação vai até a linha.
Tabelas do dump SQL
As tabelas de um dump do mysqldump, pg_dump ou SQLite com suas linhas e tamanhos: um dump de 1 GB é listado em cerca de um segundo. Salve uma tabela em um arquivo que é restaurado sozinho, ou divida o dump em um arquivo por tabela; na ordem dos nomes, os arquivos restauram o banco inteiro.